技能装好了,智能体却装作看不见:当技能库变大,路由就开始崩塌
技能装好了,智能体却装作看不见:当技能库变大,路由就开始崩塌
一句话版本:当智能体的技能库从几十个涨到上千个,那些「装了却没加载」的技能会越来越多——召回率从 73.6% 跌到 27.4%,近一半任务干脆一个技能都不加载;但只要把「选技能」和「干活」分开,召回率立刻回到 73.9%。
技能(Skill)是当下智能体最诱人的能力之一:把某类任务的专家经验封装成一段可复用的指令,智能体需要时按需加载,用完即走。听起来很美——技能越多,智能体越能干。但现实往往是:技能库建得越大,智能体反而越「健忘」。
装得下,不一定用得起
这篇论文问了一个朴素却关键的问题:当技能库膨胀到上千个,智能体还能在执行任务时挑出对的技能吗?
研究者用的测试床是 SkillsBench——82 个真实任务,每个都配好了「黄金技能」(真正该被加载的那个)。实验设计很干净:任务不变、黄金技能不变,只是往库里不断添加无关技能,看智能体在执行时还能不能把对的那个挑出来。
结果触目惊心。当无关技能从 0 增加到 1000 个:
- 加载召回率从 73.6% 暴跌到 27.4%——该加载的技能,近四分之三被错过;
- 零加载率从 9.3% 飙升到 51.6%——超过一半的任务,智能体干脆一个技能都不加载,空手干活;
- 而端到端成功率 Pass@3 的跌幅没那么夸张,因为很多任务硬做也能勉强完成,只是「没用上该用的技能」。
- 技能库不是越大越好,超过某个规模,边际收益会变成边际损失;
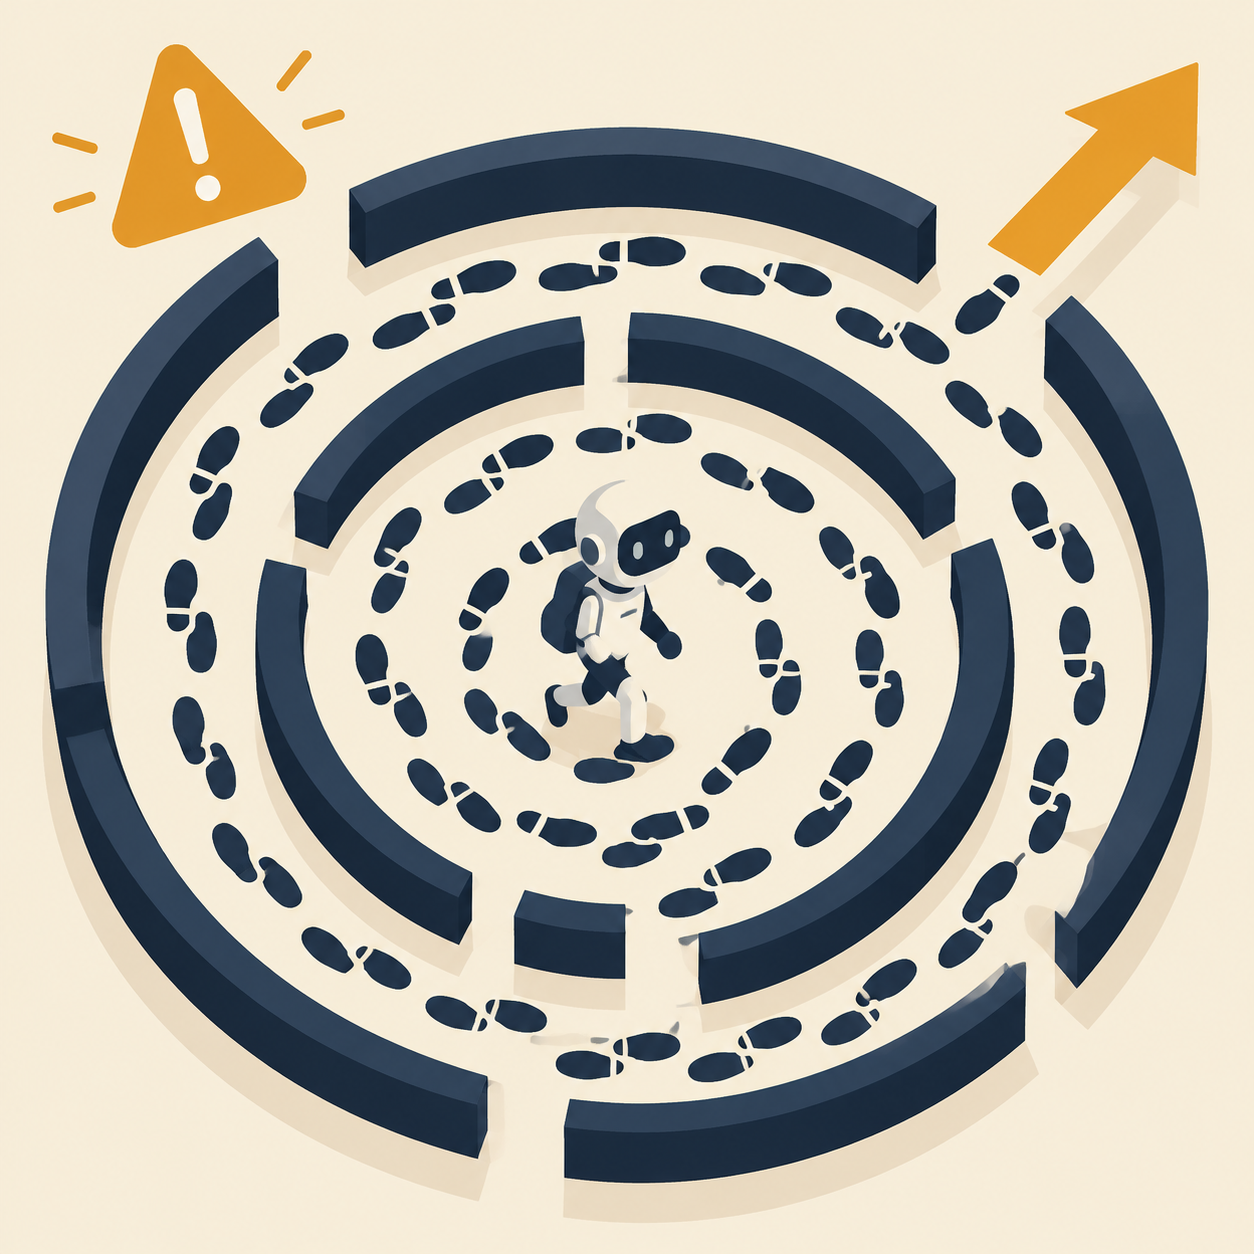
关键洞察:技能没丢,是「选」出了问题
这里最反直觉的发现是:技能并没有变难认。
研究者做了对照——让同样的模型面对同样的完整技能库(同样 1000 个无关技能在场),但只问它「该选哪些技能」,不要求它同时干活。这时候,选中黄金技能的召回率依然有 73.9%,和技能库很小时差不多。
也就是说:相关技能依然可识别,它们是在「路由变成执行子任务」的过程中被丢掉的。问题不出在技能本身,出在让智能体一边解题、一边从一堆描述里挑技能这种设计上。
为什么会这样?论文归因到两点:
1. 语义干扰(semantic interference):成百上千条技能描述挤在上下文里,彼此语义重叠,把真正相关的那个淹没了。研究者做了一个巧妙的对照——只屏蔽无关技能的描述、保留它们的文件(上下文长度不变),召回率就大幅回升。这说明干扰来自描述文字本身,而非上下文长度。
2. 指令干扰(instruction interference):当「选技能」和「执行任务」在同一步里争抢智能体的注意力,任务指令会压制技能选择的完整性。即便明确要求智能体先规划技能使用,召回率依然偏低——只要元数据还在场,这种干扰就挥之不去。
缓解之道:把「选」和「做」拆开
论文给出的实用解法,和一个朴素直觉吻合:显式预选(explicit preselection)。
不要让智能体在埋头干活时顺便挑技能,而是先单独走一步「从库里选技能」,选完再进入执行。这一步把路由从执行的子任务里解放出来,召回率回到 73.9% 的水平。
当然这有代价:多一步意味着更高的延迟,且并非所有任务都能被预先描述清楚(覆盖范围有限)。但论文指出,对于那些技能库已经长到几百上千、路由开始崩塌的系统,这点延迟是值得付的——否则你精心积累的技能资产,大半都在静默失效。
这对构建智能体的人意味着什么
这篇论文的结论,对任何想让智能体「越积累越强」的团队都是一记提醒:
- 加载机制比技能本身更重要——再好的技能,加载不出来等于没有;
- 「先选后做」是工程上可落地的折中,尤其当你的技能库已经过了临界点。
在 BuddyMe 的设计里,技能采用三级渐进加载:不是把所有技能一股脑塞给智能体,而是按需、分层地把真正相关的技能送到执行上下文里。这正对应了论文的发现——让技能选择保持轻量、可控,而不是让智能体在汪洋般的技能描述里自己捞针。当你积累的技能越来越多,加载机制的健康度,往往比技能数量本身更决定智能体的实际能力。
论文:*Lost in Implicit Routing: How LLM Agents Fail to Load Relevant Skills at Scale*(arXiv:2610.18522),配套代码见 github.com/jinlinll/lost-in-implicit-routing。
>
BuddyMe 每日免费 4500 万 Token,三级技能渐进加载,让技能用得起来而不只是存得下来。