让 AI 自己教自己:多智能体自监督打开了递归自我改进的口子
让 AI 自己教自己:多智能体自监督打开了递归自我改进的口子
一句话版本:当模型产出超出人类专家的评估能力,谁来当老师?答案是「模型自己组织的智能体团队」——MASS 方法让基础模型自己提出、执行、评估多智能体工作流,再拿这些轨迹反过来训练自己,两轮循环性能提升 1.2-1.6 倍。
一句话版本(先给结论)
伯克利与 Sakana 团队提出 MASS(多智能体自监督):交替进行「进化式工作流优化」与「自生成轨迹微调」——模型先为任务进化出最优的多智能体编排(角色分工+信息路由),再把这些多智能体轨迹当训练数据微调自身。两轮循环后,同等 token 产出性能提升 1.2-1.6 倍;且用多智能体轨迹训练的学生模型,胜过用 1.4 倍数据训练的单智能体学生——自监督的信号质量更高。
一、递归自我改进的「老师瓶颈」
递归自我改进(RSI)是智能体领域的圣杯方向:模型改进模型,能力滚雪球。但它在开放性任务上卡在一个根本瓶颈——监督信号从哪来?
代码可以跑测试验证对错;但「一份研究方案好不好」「一个策略优不优」这类不可验证任务,连人类专家都评不稳;
单模型自我批评(同质回路)效果差:同一个模型用同一套偏见审自己,错的地方照样错。
论文的解法一针见血:单个模型不行,就让它组织一支风格各异的智能体团队来互相监督。
二、MASS 的两步循环:先进化编排,再吃轨迹
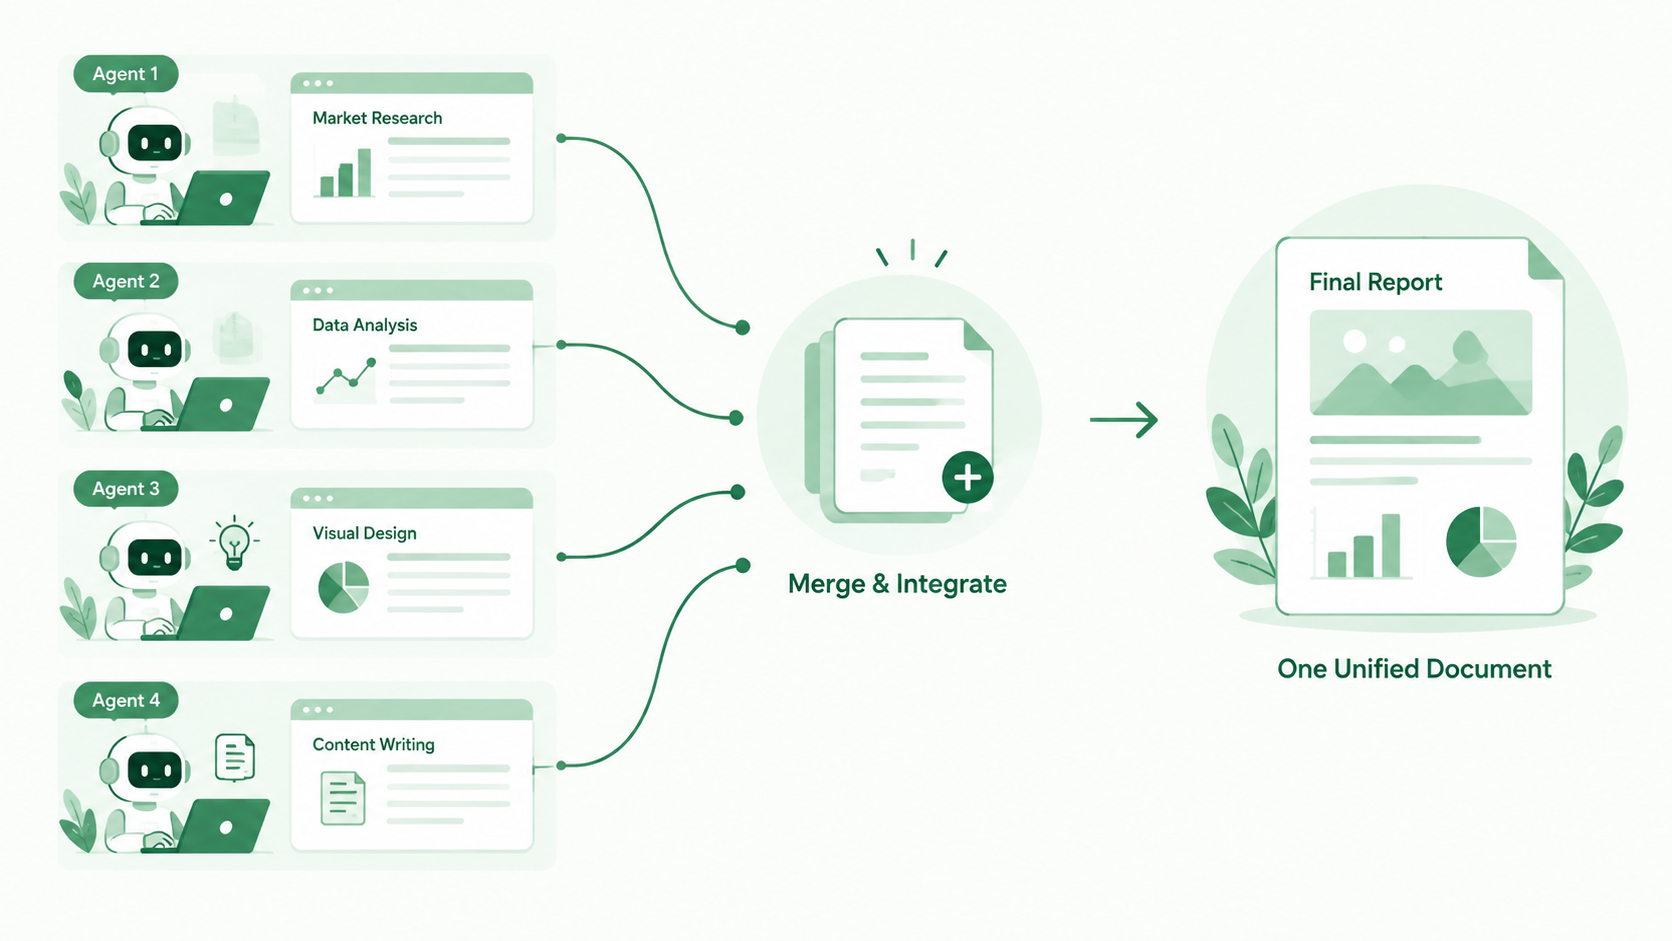
第一步:进化式工作流优化。 基础模型针对任务提出多种多智能体工作流(像计算图一样的编排:哪些角色、谁向谁传递什么信息),执行后自评效果,在结构护栏约束下做进化搜索——保留有效分工,淘汰冗余路由。多智能体拓扑在复杂推理上的优势(异质视角+分工)就这样被「搜」了出来。
第二步:自生成轨迹微调。 把最优工作流产生的执行轨迹(含中间步骤与反馈)作为训练数据,微调基础模型本身。改进后的模型又成为下一轮更强的「工作流设计者+评估者」——递归自举开始滚动。
三、三个关键结果
性能:四个开放性公开基准上,两轮 MASS 后每 token 产出性能提升 1.2-1.6 倍;
训练效率:用多智能体轨迹训练的学生模型,超过用 1.4 倍 token 训练的单智能体学生——多智能体轨迹里「分工+路由+反馈」的结构信号,比单线思维链密度更高;
持续滚动:模型变强后,它设计的工作流和评估也更准——改进会自我强化,而非一轮见顶。
四、对智能体产品的三条启示
1. 「自监督数据」是新的数据护城河。 你的智能体系统每天跑出的高质量轨迹(尤其是多智能体协作轨迹),就是下一版模型的训练金矿——产物落盘不只是为了回溯,更是数据资产。
2. 编排本身值得被优化,而不是被手写。 哪个环节配什么角色、信息怎么路由,进化搜索+护栏约束比人工设计更能逼近任务结构——把「工作流编排」从配置项升级为可学习对象。
3. 团队化是多智能体的第一性价值。 不是「人多力量大」的堆料,而是异质视角提供的监督信号——这恰恰是自监督回路里最缺的东西。
结语
RSI 的叙事长期停在「模型评审模型」的同质回路里,MASS 用多智能体拓扑把回路打破了一角:当评估者足够多样,自己教自己才成立。做多智能体平台的团队,你们的轨迹数据正在升值。
论文:Recursive Self-Improvement through Multi-Agent Self-Supervision(arXiv 2610.12176)
BuddyMe 每日免费 4500 万 Token。