动态注入 Skill:从 Tool 动态注册到 Skill 按需注入的工业级架构实践
动态注入 Skill:从 Tool 动态注册到 Skill 按需注入的工业级架构实践
在 Agent 运行时根据用户意图,从 Skill 库检索最相关技能,按需注入 LLM 上下文——实现 Token 精细化管控、模型决策准确性和零代码扩展。
一、问题背景:为什么需要动态注入
传统 Agent 架构中,工具和技能以硬编码方式写死在代码里。这种方式在企业级持续迭代场景下暴露出五大痛点:
| 问题 | 具体表现 | 影响 |
|---|---|---|
| 新增需改代码 | 上线新工具需修改核心代码,走完整 CI/CD | 迭代效率极低 |
| 重启才生效 | 修改后必须重启 Agent 主进程 | 用户体验差 |
| Token 爆炸 | 全量工具 Schema 一次性注入上下文 | 推理成本飙升 |
| 模型错选幻觉 | 上下文中工具过多,LLM 频繁选错或编造工具 | 任务成功率下降 |
| 运维成本高 | 工具生命周期无法在运行时管控 | 生产风险大 |
随着 Agent 生态的发展,业界逐渐认识到:Tool 解决的是"能不能做"的问题,Skill 解决的是"怎么做才专业"的问题。
动态注入 Skill 的本质是:在 Agent 运行时,根据用户意图从 Skill 库中检索最相关的技能,按需将其指令文本注入 LLM 上下文窗口,而非一次性全量灌入。
二、核心概念辨析:Tool vs Skill
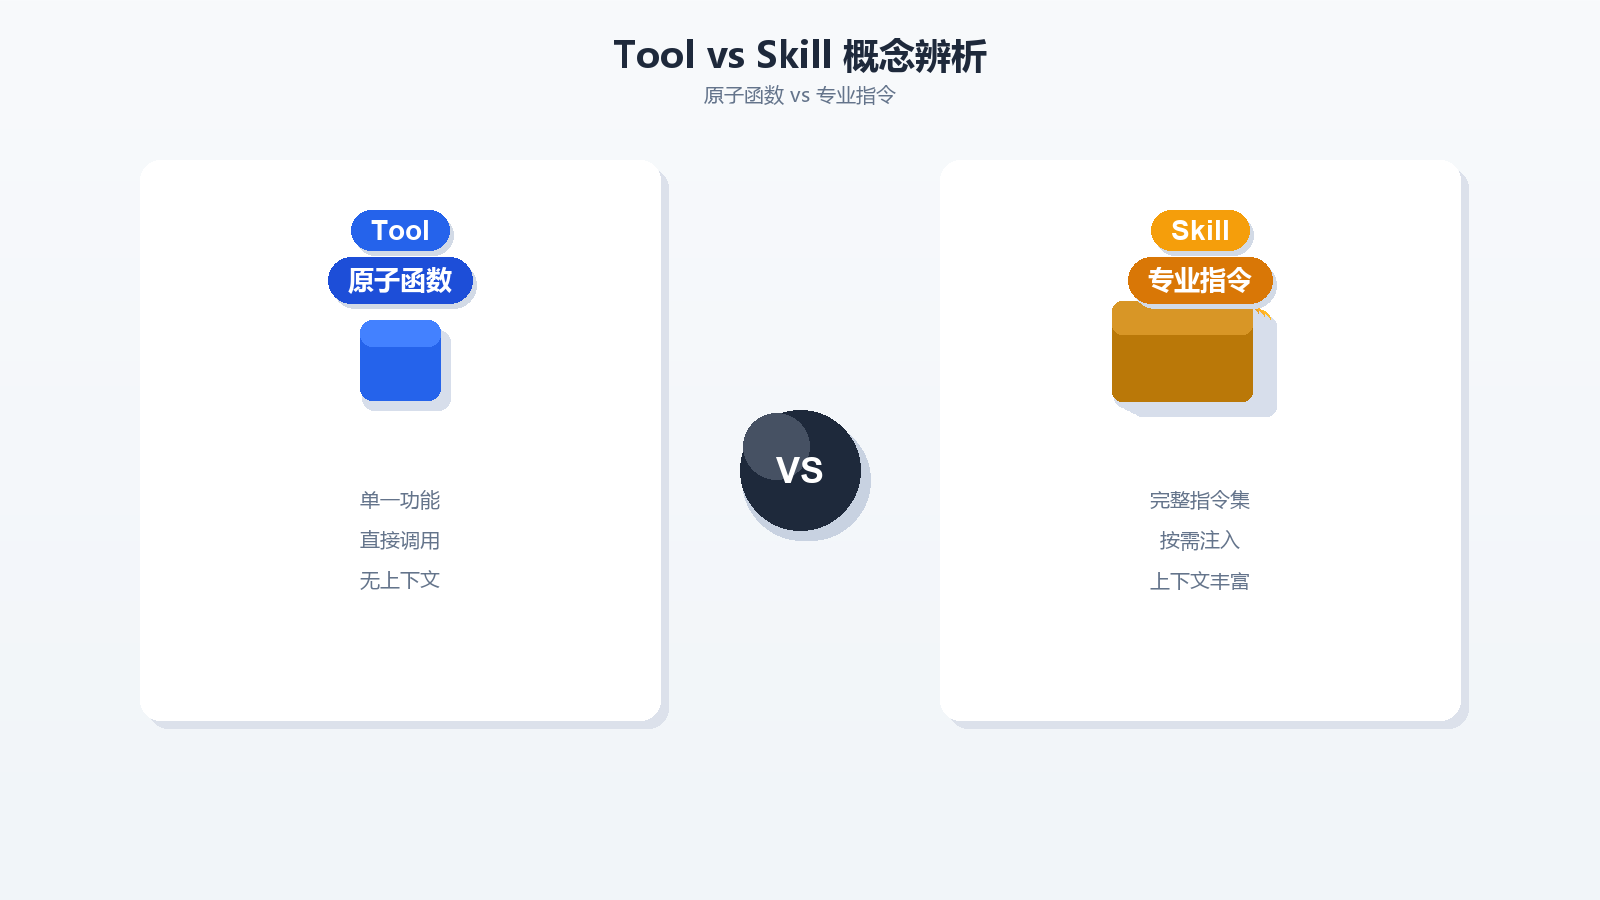
Tool 是原子化的功能单元(如 read_file、bash),对应一个函数调用;Skill 是封装了专业知识、最佳实践和执行流程的元工具,本质是"带目录的说明书",通过 Markdown 指令文本注入 LLM 上下文。
| 维度 | Tool(工具) | Skill(技能) |
|---|---|---|
| 本质 | 原子化函数调用 | 封装专业知识的指令文本 |
| 载体 | Python 函数 / MCP RPC | Markdown 文件(SKILL.md) |
| 注入方式 | Function Calling Schema | System Prompt 文本拼接 |
| 粒度 | 单一操作 | 完整流程 |
| Token 占用 | Schema 约 100-300 Token | 指令文本 500-5000 Token |
Skill 是一种"元工具"(Meta-Tool)。它不直接执行操作,而是为 LLM 提供执行某类任务的专业指导。例如 weather-skill 不自行查询天气,而是告诉 LLM 如何调用 weather.py 脚本、如何解析城市编码、如何格式化输出。
三、三位一体机制:注册 → 发现 → 注入
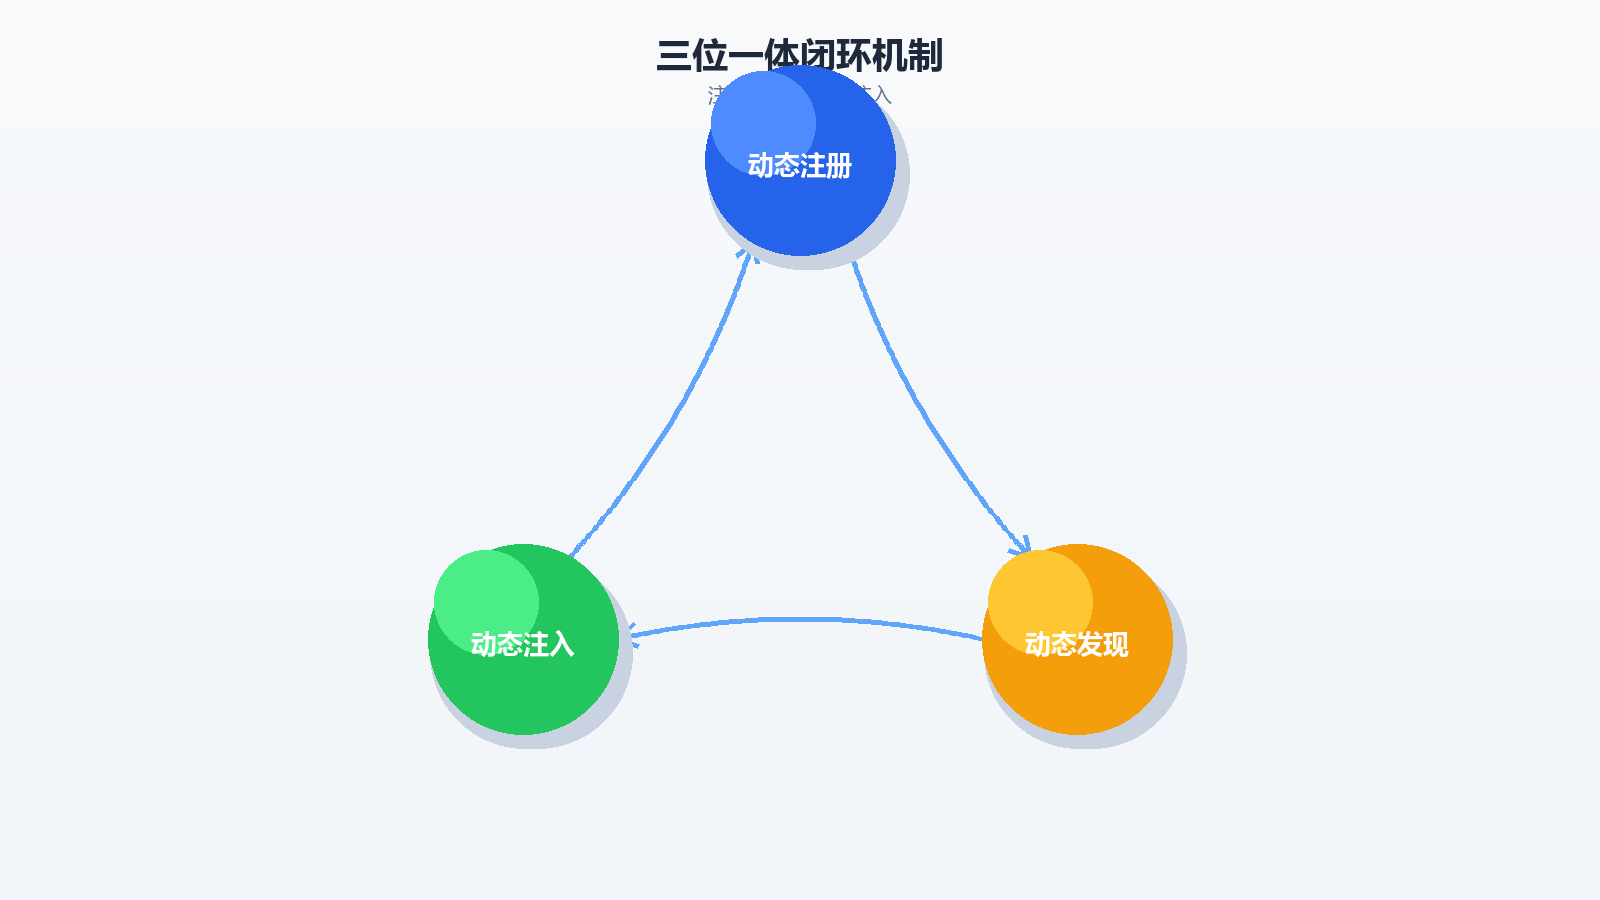
动态注入 Skill 的完整体系包含三个环节,形成闭环:
- 动态注册:Skill 以文件形式放入
skill_library/skills/目录即完成注册,无需代码改动 - 动态发现:系统启动时递归扫描目录,解析每个 SKILL.md 的元数据,构建内存注册表
- 动态注入:运行时根据用户输入,通过 BM25 检索最相关的 Skill,按分数阈值分级注入 LLM 上下文
这一机制带来三个核心价值:
- Token 精细化管控:只注入与当前任务相关的 Skill,避免无关技能浪费上下文窗口
- 模型决策准确性:减少上下文中的噪声,降低 LLM 选错技能的概率
- 零代码扩展:新增 Skill 只需在文件系统中创建目录和文件,无需修改任何代码
四、顶层架构与核心模块
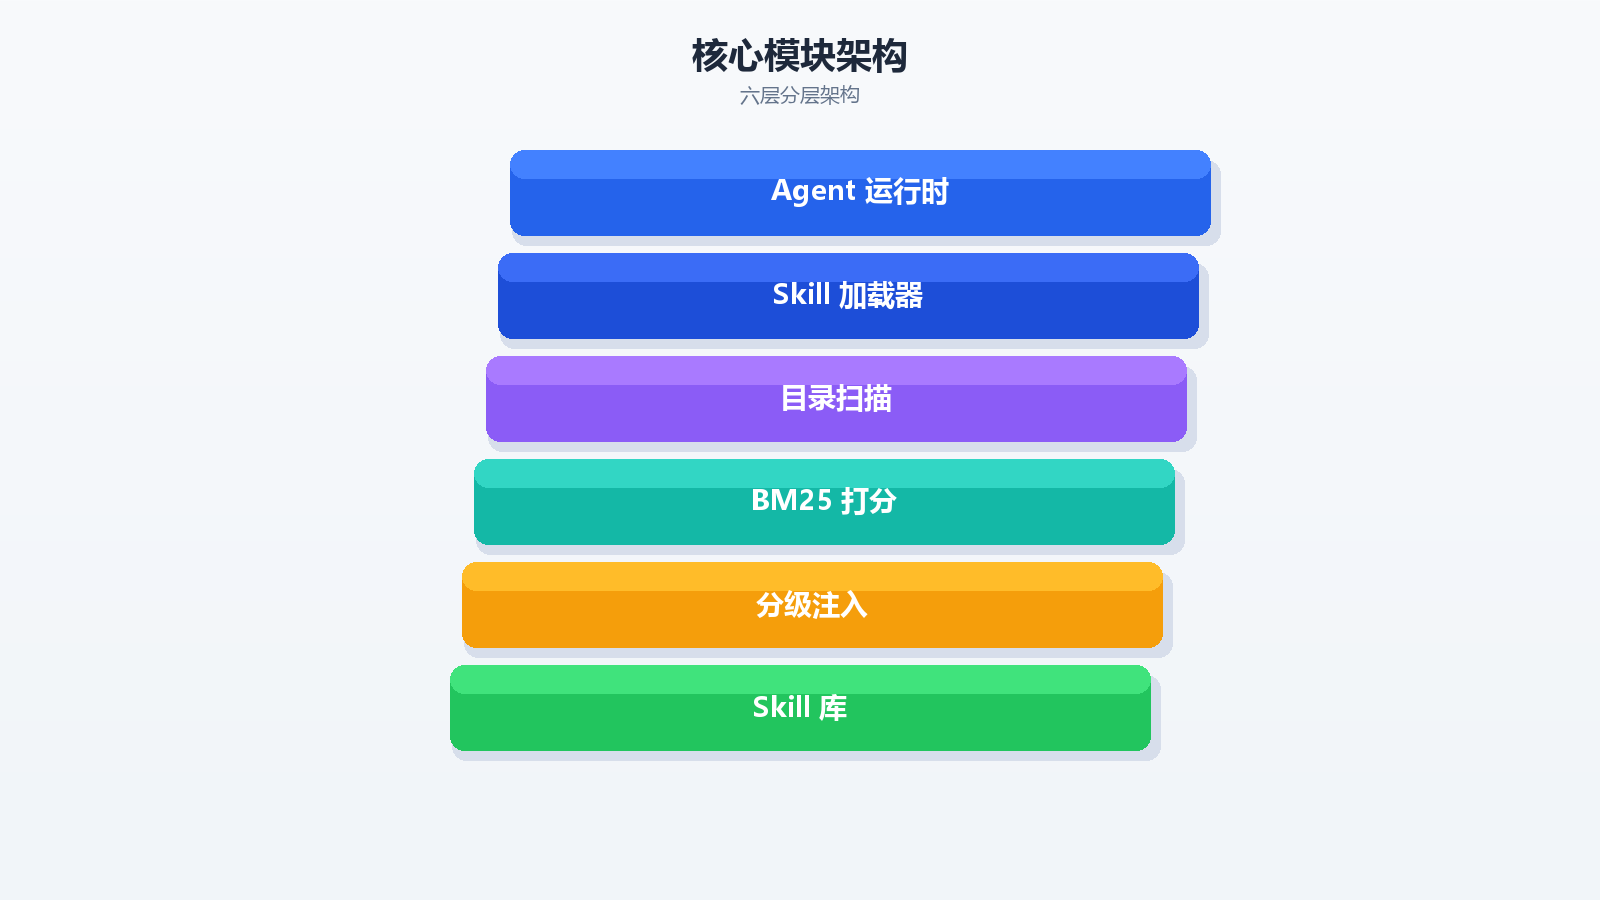
整个体系遵循五大设计目标:动态注册、动态发现、动态注入、双端统一、全生命周期管控。
核心加载器 SkillInvokeLoader 承担三大职责:
_scan():递归扫描 skills 目录,只解析 frontmatter,不读 instructions_rank_skills():BM25 打分,返回按分数降序的候选列表find_nearest_skill_text():分级注入,高分完整注入 + 低分轻量菜单
Skill 按 tier 分为四层:
| Tier | 定位 | 示例 |
|---|---|---|
| domain | 领域专业知识 | python-patterns、frontend-design |
| integration | 外部集成能力 | weather-skill、qqmail |
| reference | 参考方法论 | emergence-paper-orchestra |
| packaging | 打包部署 | windows-exe |
五、BM25 检索:纯本地语义匹配引擎
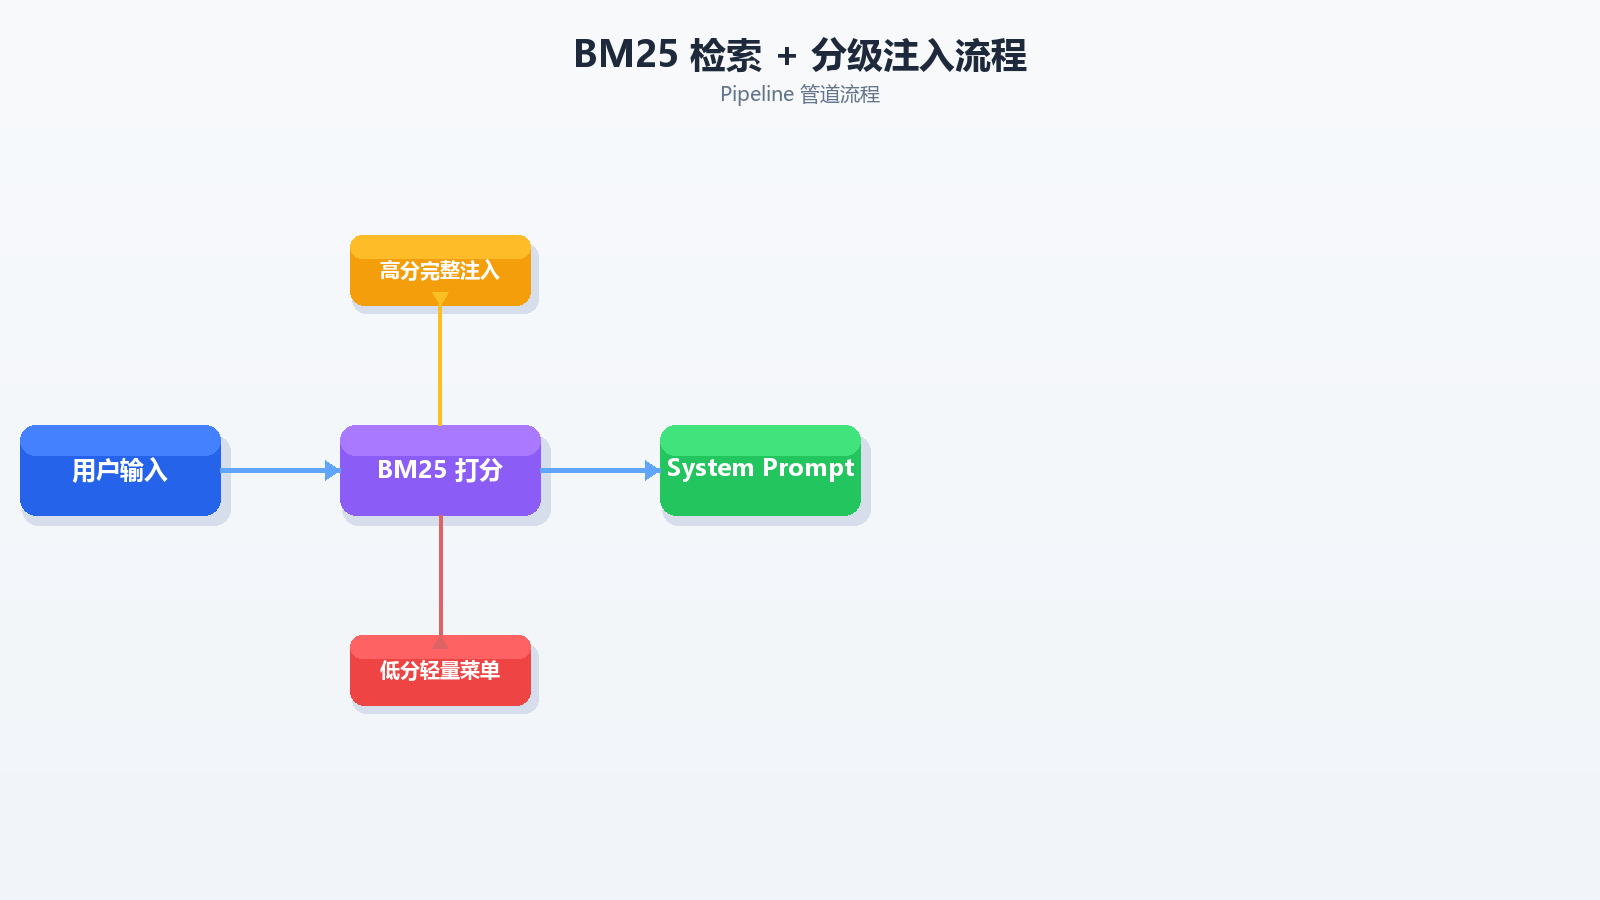
Skill 检索的核心挑战是:给定用户输入,从所有 Skill 的 name + description 中找到最相关的几个。项目选择 BM25 算法,原因如下:
- 零外部依赖:不需要 embedding 模型、不需要向量数据库、不需要 API 调用
- 纯本地计算:启动即用,无网络延迟
- 可解释性强:分数由 TF(词频)、IDF(稀有度)、长度惩罚三因子决定,透明可调
- 中英文兼容:中文按单字分词、英文按空格分词,无需额外分词器
BM25 的核心公式为:
BM25(D, Q) = Σ IDF(qi) × [ TF(qi, D) × (k1 + 1) ] / [ TF(qi, D) + k1 × (1 - b + b × |D| / avg_dl) ]
其中 k1 默认 1.5(词频饱和参数),b 默认 0.75(长度惩罚参数)。BM25 方案的优势在于零维护成本:新增 Skill 不需要更新任何映射配置,即可自动参与检索。
六、懒加载机制:10 倍启动提速
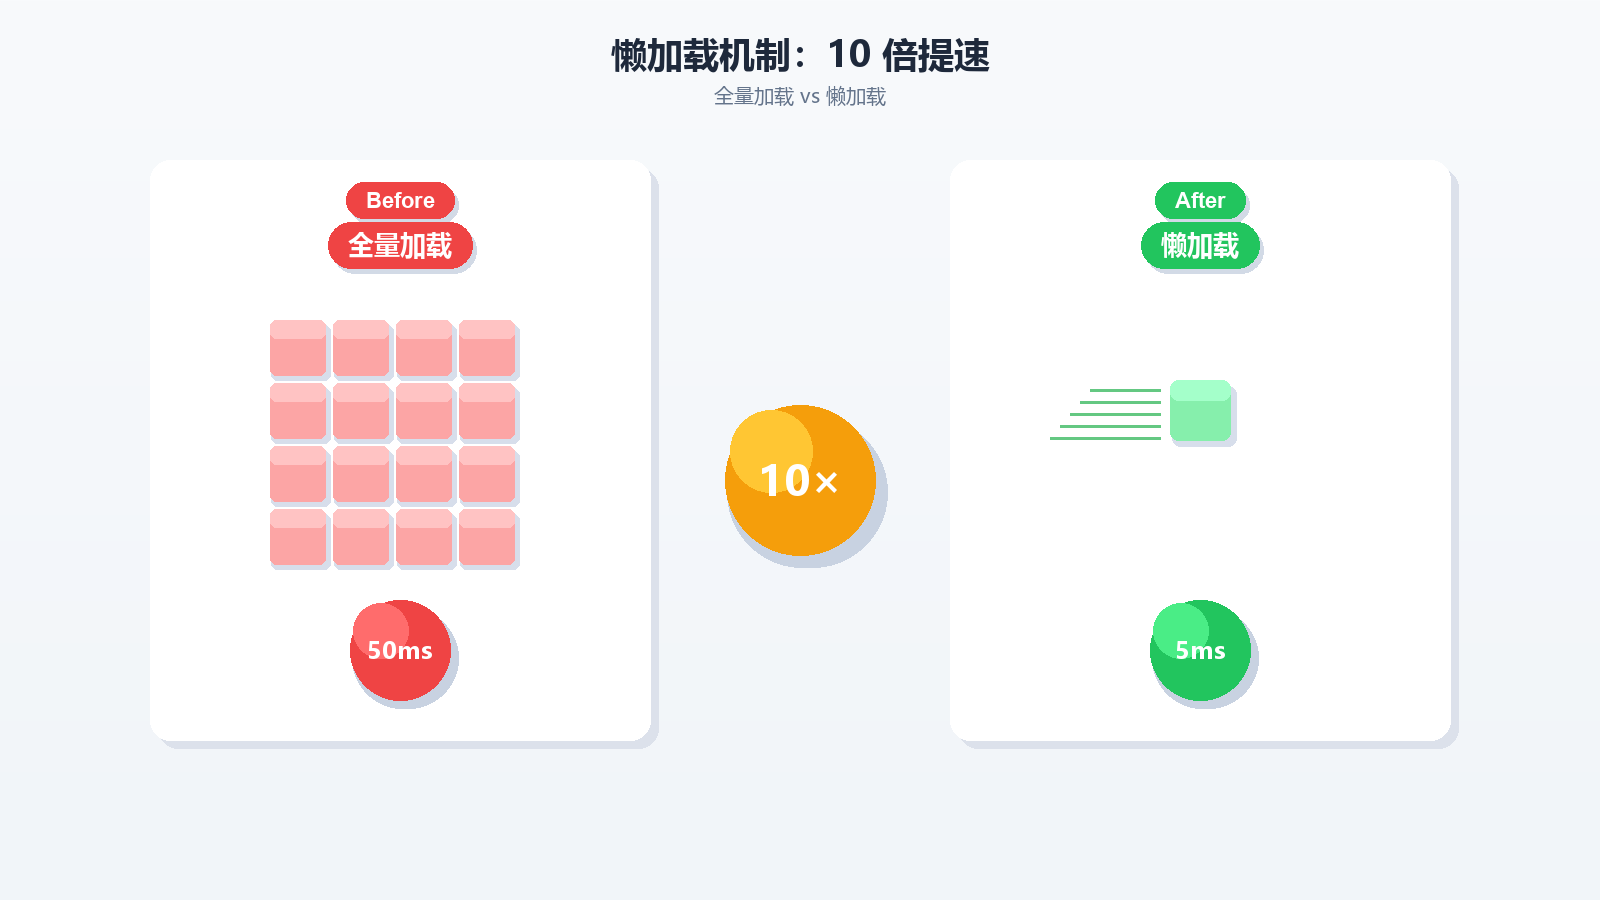
如果启动时读取所有 SKILL.md 的完整内容,14 个 Skill(部分超过 40KB)会导致启动延迟显著增加。项目采用懒加载策略:初始化时只读 frontmatter,instructions 用到时才从磁盘读取。
| 指标 | 全量加载 | 懒加载 | 优化幅度 |
|---|---|---|---|
| 14 个 Skill 初始化 | ~50ms | ~5ms | 10 倍 |
| 42KB 大文件影响 | 拖慢启动 | 不影响 | 完全消除 |
| BM25 搜索所需数据 | 全量(浪费) | 仅 frontmatter | 精准匹配 |
这与 Claude Agent Skills 的"渐进式披露"(Progressive Disclosure)机制异曲同工:元数据常驻、指令按需加载、资源动态读取、脚本外部执行。两种实现都遵循同一原则——上下文窗口是稀缺资源,只注入当前任务真正需要的内容。
七、分级注入策略:Token 降低 80%
即使通过 BM25 检索到了相关 Skill,也不能无差别地将所有候选 Skill 的完整 instructions 都注入上下文。项目实现了基于 BM25 分数的两级注入策略:
- 分数 ≥ 5.0(FULL_SCORE_THRESHOLD):完整注入 instructions(懒加载读取 +
{SKILL_DIR}替换) - 分数 < 5.0:仅进轻量菜单(一行:name | 分数 | 描述)
假设有 12 个 Skill,平均 instructions 2000 Token:
| 策略 | 注入 Token 量 | 说明 |
|---|---|---|
| 全量注入 | ~24000 Token | 12 × 2000,上下文爆炸 |
| 分级注入(top_n=3,2 个高分) | ~5000 Token | 3 行菜单 + 2 × 2400 完整指令 |
| 仅菜单(无完整注入) | ~150 Token | 3 行菜单,极轻量 |
分级注入在保证相关信息可用的前提下,将 Token 消耗降低了约 80%。
八、两条注入路径
路径 A:单 Loop 模式
用户输入 → find_nearest_skills(user_input, top_n=3) → BM25 检索 → 拼入 system prompt → LoopAgent 推理执行。
路径 B:Plan-Execute 模式
- Plan 阶段:
find_nearest_skills(goal, top_n=11),规划阶段需要更宽的视野 - Execute 阶段:每个 task 的 LoopAgent 继承 Plan 阶段选出的 ALL_skills,按 task 的 user_input 再次检索注入
| 维度 | 单 Loop 模式 | Plan-Execute 模式 |
|---|---|---|
| 检索次数 | 1 次 | 2 次(Plan + Execute) |
| top_n | 3(精选) | 11(Plan)/ 3(Execute) |
| 适用场景 | 简单任务 | 复杂多步任务 |
九、幻觉抑制六项措施
Skill 动态注入引入了新的幻觉风险:误匹配、过度套用、指令冲突、资源幻觉。项目实现了六项抑制措施:
| 措施 | 实现 | 效果 |
|---|---|---|
| 分数阈值过滤 | FULL_SCORE_THRESHOLD = 5.0 |
避免低相关 Skill 误导 |
| 条件式使用规则 | "仅当相关性 ≥ 阈值且强匹配时才执行" | 不强制 LLM 使用 Skill |
| 用户意图优先 | "以用户意图为准" | 防止 Skill 覆盖真实需求 |
| 低分降级 | "直接用工具" | 无 Skill 时不强行注入 |
| top_n 限制 | 执行 3 / 规划 11 | 控制候选数量 |
| 描述精确化 | description 含 Use when 触发条件 |
提高匹配精度 |
十、全链路容错与降级
当 Skill 注入出现异常时,系统采用分级降级策略:
正常流程:BM25 检索 → 高分完整注入 + 低分菜单
    ↓ (BM25 无匹配)
降级 1:仅注入空字符串,LLM 直接使用工具
    ↓ (工具也失败)
降级 2:LLM 自主推理,无 Skill 辅助
这种设计确保了 Skill 体系是"锦上添花"而非"缺之不可",即使 Skill 注入完全失效,Agent 仍能正常工作。
关键容错环节包括:文件扫描异常跳过、Frontmatter 解析 fallback 命名、BM25 空结果返回空字符串、懒加载文件删除保持空块、Plan-Execute 传递失败独立检索。
十一、演进方向与未来展望
当前实现的局限与演进路线:
| 当前状态 | 短期演进 | 中长期 |
|---|---|---|
| 文件系统扫描 | watchdog 热加载 | 远程 Skill 仓库 |
| BM25 关键词匹配 | Embedding 语义检索 | 混合检索 BM25+向量 |
| 单机内存注册表 | Redis 集群同步 | 分布式 Skill 市场 |
| 无权限控制 | RBAC 权限绑定 | 多租户隔离 |
| 无版本管理 | Git 版本追踪 | 灰度发布 + 回滚 |
从行业实践来看,Skill 动态注入正在向标准化、市场化、智能化、安全化、协作化五个方向发展。Agent Skills 作为开放标准将推动跨平台 Skill 互操作,Skill 市场将允许开发者发布和订阅 Skill,类似应用商店。
总结
动态注入 Skill 的核心思想可以概括为一句话:上下文窗口是稀缺资源,只注入当前任务真正需要的内容。
通过"文件系统即注册表"实现零代码扩展,通过 BM25 检索实现精准匹配,通过懒加载实现 10 倍提速,通过分级注入实现 Token 降低 80%,通过六项幻觉抑制和全链路容错确保系统可靠性。这一架构代表了 Agent 从"专科医生"向"总住院医师"演进的关键能力底座。